我是正太,一名大学生,喜欢研究计算机技术。这篇文章记录我把一份 28 页的党政风答辩 PPT 从零做到交付的全过程,重点放在技术选型、踩过的坑和最后沉淀下来的那套东西。
一、先看约束,约束决定选型
这份稿子是学院团日活动的成果汇报答辩稿。接手时它有三条硬约束,后面所有的技术取舍都是被它们逼出来的:
交付物必须是原生
.pptx。要拷到答辩电脑上用 PowerPoint 打开,而且稿子随时可能被改,所以要能当场改字。这一条直接排除了 HTML 网页幻灯片和整页图片式 PPT 两条路线。素材在微信里。活动文案、照片、审稿意见全散在聊天记录和文件里,得先把它读出来。
排版规范是别人定的。字体、对齐、装饰都有明确要求,而且被打回过好几轮。
我一开始的直觉是"装个现成的 PPT skill"。翻了一圈 X 和 GitHub 上的推荐,结论是:没一个适合。那些工具大多是两种思路——输出 HTML 演示,或者整页生成图片再拼成 PPT。前者在答辩电脑上打不开,后者改不了字。
所以选型定下来:python-pptx 改文件 + LibreOffice 渲染核对 + 脚本验收。
二、第一关不是排版,是「把微信聊天记录读出来」
我原本以为重活是排版。真正卡住的是数据获取。
目标是读出与某个联系人的全部聊天记录,要文字、图片和文件。试过并失败的路子,按顺序列一下,给后来者省点时间:
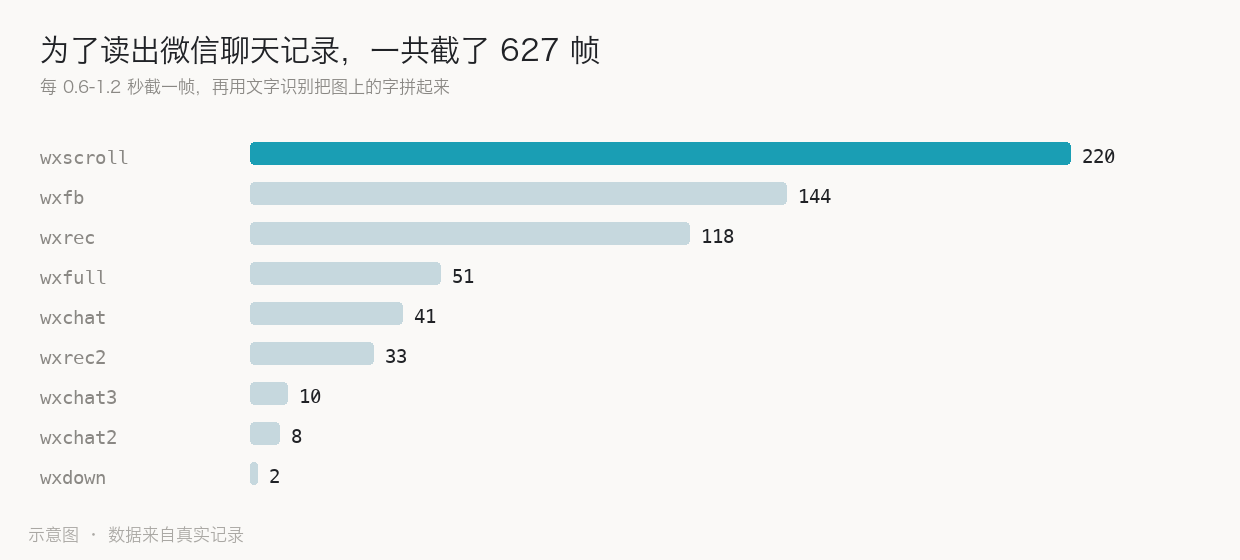
最后能走通的方案特别笨:屏幕录制权限 + 人工滚动 + 定时截屏 + OCR。用户手动一屏一屏往下翻,程序每 0.6–1.2 秒截一帧,最后一共 627 帧,用 Vision OCR(zh-Hans)识别后去重拼接。
这套方案的工程成本值得记一笔:
627 帧截图,分布在 9 个临时目录里
5 批 OCR 批处理,产出 4 份文本
约 40 次整图查看(人工核对渲染页和批注截图)
后续还有 26 轮全片渲染核对(每轮 = pptx→pdf + pdf→png)
结论:这一整轮里最大的 token 开销不在"改 PPT",而在"把非结构化的聊天数据读出来"。 如果一开始就知道要这么做,我会先把预算和方案定在这件事上,而不是先去做版式。
三、排版真正的难点是「量」,不是「审美」
进入排版之后,被反复打回的问题里,绝大部分不是"不好看",而是几何量错了。四个典型案例:
1. 字体:必须连主题字体一起改
第一轮用了 macOS 自带的字体,到 Windows 上被替换,中文和数字变成两套。第二轮改成微软雅黑——只改了正文 run,没改主题字体,文件里 ppt/theme/theme1.xml 的 majorFont/minorFont 还是 Calibri,另外还有 27 处 +mn-* 引用和 12 处 Arial。第三轮才把主题字体和残留一起清干净。
规则:改字体要同时改三处——每个 run 的 a:latin/a:ea/a:cs、主题的 majorFont/minorFont、以及所有残留的显式字体声明。
2. 装饰角标插进了页脚 0.22 英寸
页面底部左右各有一个 L 形装饰角标。肉眼看上去只是"有点怪"。量出来才发现:它的横笔在 6.60 英寸,竖笔从 6.60 一直伸到 7.28 英寸,而页脚红条从 7.06 英寸开始。也就是说,它插进页脚 0.22 英寸。
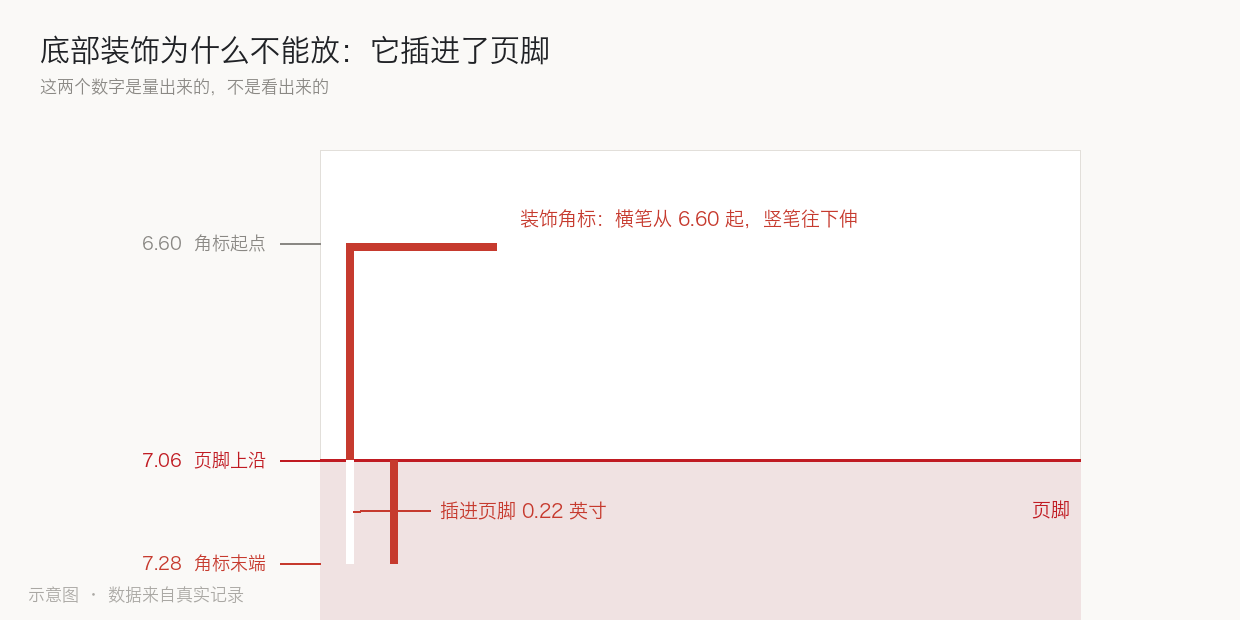
这类问题看是看不出来的。量一次就明白。
3. 四宫格填不满,是物理上填不满
四张照片排 2×2,摆完左右各空出一大块。量出来:那四张照片的宽高比决定了行高上限是 2.6 英寸,横向最多占 7 英寸左右。版心宽 11.93 英寸,剩下的空间不是排版没排好,是几何上填不满。
解决办法是换思路:用浅色底衬把空白收掉,而不是继续缩图片或者硬塞装饰。
4. 行内间距全篇只允许一个取值
图片间距只要出现 0.12、0.15、0.2 三种取值,整页就会显得乱。最后定死:同一行等高、顶边对齐、间距统一 0.15 英寸,整行撑满版心(左右 0.70–12.63 英寸),撑不满时左右边距必须相等。
顺带一提图片处理的四个典型 bug,都是这一轮踩出来的:
四、验收清单:把"我觉得对齐了"变成脚本
每次改完我都跑一遍这几项,全部是脚本判定的,不靠肉眼:
页数 == 期望值(
check_office.py --count N期望verdict: pass)每张图:显示宽高比 == 源图宽高比(0 张变形)
每张图:不越界(版心 0.70–12.63,上 1.19,下 6.70)
行内间距取值集合 ==
{0.15}旧装饰残留 == 0(按几何 + 颜色签名匹配)
run 级字体取值集合 ==
{微软雅黑};主题majorFont/minorFont的 latin/ea/cs 同样是微软雅黑与源版逐形状比对:差异条数 == 预期的改动条数
第 7 项最有用。它保证"只改了该改的地方"——插页之后能确认除页码外没有别的页被动过。
渲染核对用 LibreOffice:
# pptx → PDF(本机没有微软雅黑,报 missingFonts 是正常的,只能判断版式)
node "$LOCLI" convert --input deck.pptx --output out.pdf
# PDF → 逐页 PNG
pdftoppm -png -r 90 -f 1 -l 26 out.pdf pages/p
注意一个坑:直接对 pptx 渲染会得到空白页,必须先转 PDF 再渲染。
五、把它沉淀成可复用的东西
这一轮最有价值的产出不是那份 PPT,是三样东西:
1. 一套排版规范(写成能执行的规则)
不是"注意对齐"这种话,而是可检验的条目:
全篇字体微软雅黑,含主题字体
行内间距只允许 0.15 英寸一种取值
图片显示比例必须等于原图比例
底部不放任何装饰(量过:正文最深 6.82 英寸,页脚从 7.06 英寸开始,中间只剩 0.24 英寸)
被否掉的装饰不要再用(飘带、星簇、竖排标语都试过,都被否了)
最后一条特别有用——它记的是负面清单。正面规则告诉 AI 该做什么,负面清单告诉它别再犯同一个错。
2. 一套空白模板
从最终稿抽出 10 个版式页(封面、目录、数据概览、三种活动页、亮点页、成果页、总结页、尾页),内容全清掉,只留版式和装饰,删掉图片的位置用浅色底衬标出来。
做法上有个小技巧:删幻灯片和图片时,除了删形状,还要 drop_rel 掉对应的关系,否则部件会一直躺在包里。27MB 的稿子这样能压到 98KB,非常适合放进模板仓。
3. 一个 Codex skill
把上面两样东西打包成 skill,别人复制一句话给 AI 就能装上:
安装这个 Skill:https://github.com/jiaojiezhiguang/dangzheng-ppt
目录结构:
dangzheng-ppt/
├── SKILL.md                  入口:什么时候用、硬性规范、工作流
├── assets/                   版式预览图
└── references/
    ├── style-spec.md         精确到 0.01 英寸的坐标、色值、字号
    ├── layout-rules.md       图片四条硬规则、文字容量优先级、装饰放置
    ├── toolchain.md          运行时路径、渲染命令、七项验收清单、八个踩过的坑
    └── materials.md          素材库结构,以及"接手前先扫目录找新增"的流程
六、八个踩过的坑(技术向)
边遍历
slide.shapes边把元素移到spTree末尾,同一个 shape 会被匹配两次(正文曾被写了两遍)。要改位置就先取好目标,或先快照列表。同一位置常有底层纯色形状(红底框与文字框叠放),按坐标找文本框会先命中没文字的那个,赋值静默失败。找文本框要跳过空文字的。
python-pptx 新增形状会盖在既有形状之上。先加底色再加文字会遮住文字——加完底色要把文字框元素移到
spTree末尾;反过来给图片铺底衬,就插到索引 2 压到最底层。图片的白框要在重排之前建立映射,重排后再贴合,否则框留在旧位置露白。
形状几何用
Emu(x).inches;判断"同一行"用round(top, 1)分组。插页会让后面所有页码错位,插完要顺延页码。这属于必须的连带改动,交付时要主动说明。
删幻灯片要同时
drop_rel它的 rId,否则幻灯片部件仍留在包里。只裁截图顶部状态栏时,把下面那行返回键/更多按钮一起裁掉,留着两个手机按钮比不裁更难看。
七、一些数据
八、最后
这件事最大的收获不是"AI 帮我做了 PPT",而是:把每一次被否掉的原因,变成一条能执行的规则,写进文件里。
规则留在对话里,下次还得重新说一遍;写进 skill,下次它就直接照着做。
仓库在这里,MIT 协议,欢迎提 issue:https://github.com/jiaojiezhiguang/dangzheng-ppt
我是正太,一名大学生,喜欢研究计算机技术。如果这篇对你有用,欢迎到公众号找我聊聊。
微信扫码关注「小公子不才」
把「做 PPT」变成一套可复用的 skill:一次 28 页党政风答辩稿的技术复盘
本文采用 CC BY-NC-SA 4.0 许可协议,转载请注明出处。
评论交流
欢迎留下你的想法